Organiser les connaissances
Logiciel de gestion de base de données : comprendre les relations et choisir
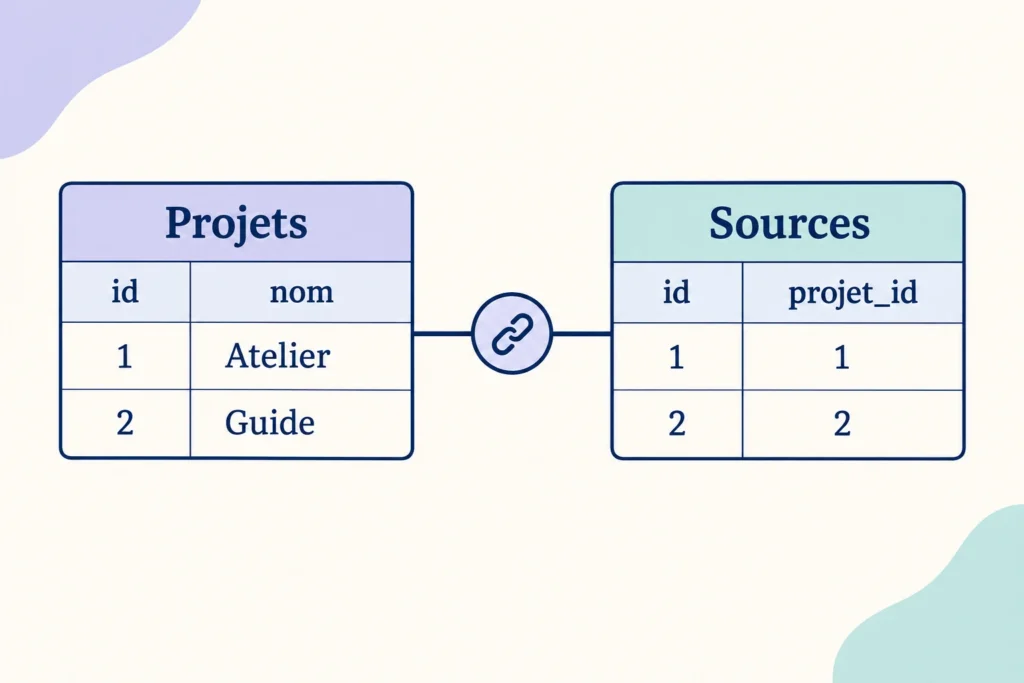
Un logiciel de gestion de base de données, ou SGBD, sert à stocker et interroger des données selon des règles définies. Pour le choisir, commencez par une question réelle : quelles informations doivent être reliées, qui doit les modifier et comment les récupérer ? Le logiciel retenu doit couvrir ces usages dans votre environnement.
Ce guide distingue les modèles de données, l’hébergement et la licence. Il contient un petit exemple SQLite effectivement exécuté le 2 octobre 2026 sur des données fictives. Cet essai explique une relation entre deux tables ; il ne constitue pas un test comparatif des SGBD.
Sommaire 7 sections
Base de données, SGBD et interface
La base contient les données. Le SGBD applique les opérations et les contraintes prévues. L’interface permet à une personne ou à une application de travailler avec ce système. Ces trois rôles peuvent être réunis dans un produit ou répartis entre plusieurs composants.
SQL est un langage utilisé pour interroger certains systèmes ; ce n’est pas une catégorie d’hébergement. Le cloud décrit un mode de déploiement. Open source décrit des conditions de licence. Un système peut donc être relationnel, hébergé dans le cloud et open source à la fois.
Une base documentaire, un tableur et un SGBD ne répondent pas toujours au même besoin. Si vous cherchez surtout à conserver des sources, expliquer des décisions et transmettre une méthode, examinez aussi la gestion des connaissances. Une nouvelle base n’est pas nécessaire pour chaque collection de notes.
Les fonctions à examiner selon l’usage
| Besoin | Fonction à examiner | Vérification utile |
|---|---|---|
| Relier un projet à ses sources | Identifiants et relations | Une référence absente est-elle acceptée ou refusée ? |
| Répondre à une question | Requête ou filtre | Le résultat correspond-il à un jeu connu ? |
| Travailler à plusieurs | Accès et opérations concurrentes | Que peut faire chaque rôle réel ? |
| Récupérer le travail | Export et restauration | La copie se rouvre-t-elle avec les données attendues ? |
Une relation ne garantit pas que le contenu est vrai. Un identifiant unique ne corrige pas un doublon métier créé sous un autre identifiant. Les contraintes doivent correspondre aux règles de votre activité et être effectivement actives.
Un exemple SQL minimal, exécuté avec SQLite
La présentation officielle de SQLite décrit un moteur SQL intégré, sans processus serveur séparé. Nous l’utilisons ici pour créer deux projets et deux sources. Chaque source doit référencer un projet existant. Le code est prévu pour une base SQLite neuve et vide :
PRAGMA foreign_keys = ON;
CREATE TABLE projets (
  id INTEGER PRIMARY KEY,
  nom TEXT NOT NULL
);
CREATE TABLE sources (
  id INTEGER PRIMARY KEY,
  projet_id INTEGER NOT NULL REFERENCES projets(id),
  titre TEXT NOT NULL
);
INSERT INTO projets VALUES (1, 'Atelier'), (2, 'Guide');
INSERT INTO sources VALUES (1, 1, 'Brief'), (2, 2, 'Documentation');
SELECT projets.nom, sources.titre
FROM projets JOIN sources ON sources.projet_id = projets.id
ORDER BY projets.id;
Résultat obtenu sur Windows avec Python 3.12.10 et SQLite 3.49.1 :
| Projet | Source |
|---|---|
| Atelier | Brief |
| Guide | Documentation |
La jointure rapproche les deux tables grâce à l’identifiant du projet. Le PRAGMA foreign_keys = ON active le contrôle utilisé dans cet essai. La documentation des clés étrangères SQLite précise que ce contrôle doit être activé pour chaque connexion concernée ; déclarer la relation ne suffit pas à présumer son application.
Ce que l’essai a vérifié
Nous avons tenté d’ajouter une source rattachée au projet inexistant 99. L’opération a été refusée avec FOREIGN KEY constraint failed. Nous avons ensuite tenté de réutiliser l’identifiant de projet 1 ; l’opération a été refusée avec UNIQUE constraint failed: projets.id.
Une copie a été créée avec la fonction de sauvegarde de la connexion SQLite exposée par Python, puis rouverte séparément. La même requête a rendu les deux lignes attendues. Le mécanisme est décrit dans la documentation Python de Connection.backup.
Cette réception porte sur deux tables et quatre lignes fictives. Nous n’avons testé ni charge, ni panne, ni chiffrement, ni accès multiutilisateur, ni restauration d’un service de production. Elle ne prouve donc pas une protection contre toutes les pertes ou erreurs.
Choisir un logiciel à partir de votre contexte
- Décrivez les données et la question que le système doit permettre de résoudre.
- Identifiez les règles : références obligatoires, doublons interdits, valeurs autorisées.
- Définissez les personnes qui lisent, modifient et administrent.
- Comparez les solutions sur les appareils, l’hébergement et les ressources techniques disponibles.
- Essayez un petit jeu synthétique, un cas invalide et une récupération.
- Documentez les limites avant d’utiliser les données réelles.
Pour une application locale, une solution intégrée peut constituer une piste. Pour un service partagé, les accès, les écritures concurrentes et l’exploitation demandent une autre étude. Aucun classement universel ni coût total inférieur ne peut être déduit du seul modèle ou de la licence.
Garder la signification des données
Chez Optimike, nous cherchons à rendre les références utilisables pour une décision ou un livrable. Dans une base, cela implique de savoir d’où vient une valeur, à quel projet elle se rapporte et quelle règle permet de l’interpréter. Une ligne correctement stockée peut rester une hypothèse ou une information ancienne.
Si vous automatisez une importation ou demandez à une IA de proposer une structure, vérifiez le résultat sur un petit ensemble connu. La personne qui valide les règles et les décisions reste identifiable. Le logiciel applique des opérations ; il ne prend pas la responsabilité du sens des données.
Pour prolonger ce travail documentaire, nos pages définition du knowledge management, choix de méthode KM et mise en place d’une transmission distinguent les besoins auxquels une base peut contribuer.
Questions fréquentes
Une base évite-t-elle automatiquement les pertes ?
Non. Il faut définir un dispositif adapté, conserver une copie et vérifier la restauration selon le mécanisme utilisé. L’essai synthétique de cet article ne valide pas votre environnement.
Open source signifie-t-il sans coût ?
Les conditions de licence et le coût d’exploitation sont différents. Hébergement, maintenance, accompagnement et temps de configuration doivent être examinés dans votre contexte.
Un graphe de notes remplace-t-il un SGBD relationnel ?
Comparez les opérations nécessaires. Relier des notes pour naviguer et appliquer des contraintes à des enregistrements ne sont pas le même geste.